人工智能基础知识全景 囊括所有知识点与基础软件开发实践
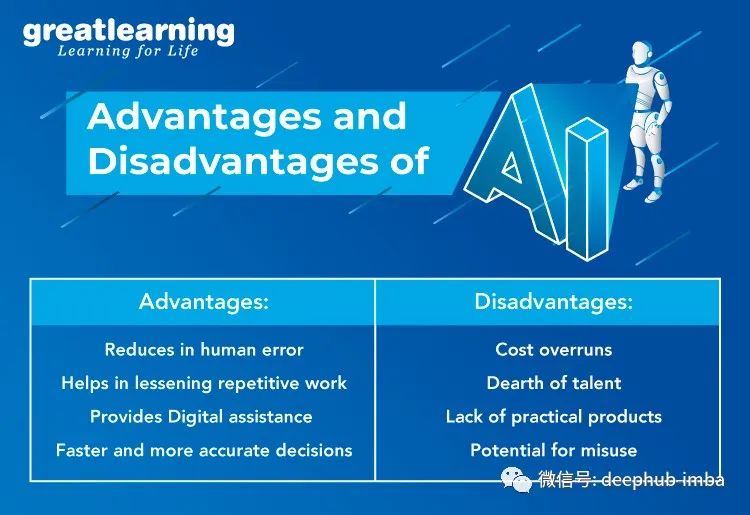
人工智能(Artificial Intelligence, AI)作为当今最具变革性的技术之一,正在深刻改变各行各业。本文旨在系统梳理人工智能的基础知识,涵盖从数学基础到核心算法、从关键技术到软件开发的完整知识体系,为读者构建一幅清晰的学习地图。
一、人工智能概述
1.1 定义与范畴
人工智能是研究、开发用于模拟、延伸和扩展人类智能的理论、方法、技术及应用系统的一门技术科学。其核心目标是使机器能够胜任通常需要人类智能才能完成的复杂任务。
1.2 发展历程
- 萌芽期(1950s-1960s):图灵测试提出,达特茅斯会议标志AI诞生。
- 第一次繁荣与低谷(1970s-1980s):专家系统兴起,随后因难以规模化而遇冷。
- 稳步发展(1990s-2000s):机器学习兴起,统计学习方法成为主流。
- 深度学习爆发(2010s至今):大数据、算力提升与算法突破推动AI在图像、语音、自然语言处理等领域取得重大进展。
1.3 AI的分类
- 弱人工智能(Narrow AI):专注于特定任务,如语音助手、推荐系统。
- 强人工智能(General AI):具备与人类相当的通用认知能力(尚未实现)。
- 超人工智能(Super AI):全面超越人类智能(理论探讨)。
二、数学基础
人工智能建立在坚实的数学基础之上,主要包括:
- 线性代数:向量、矩阵、张量运算,特征值分解,奇异值分解(SVD),为数据表示和模型参数提供数学工具。
- 概率论与统计:概率分布、贝叶斯定理、期望与方差、最大似然估计(MLE)、假设检验,是机器学习推断与评估的基石。
- 微积分:导数、偏导数、梯度、链式法则、凸优化,支撑模型训练中的梯度下降与反向传播。
- 优化理论:梯度下降法、随机梯度下降(SGD)、Adam等优化器,以及损失函数的设计与选择。
- 信息论:熵、交叉熵、KL散度,用于衡量分布差异与模型不确定性。
三、机器学习核心知识
机器学习是AI的核心分支,研究如何让计算机从数据中学习规律。
3.1 学习范式
- 监督学习:从带标签数据中学习映射关系,包括分类(如SVM、决策树、逻辑回归)与回归(如线性回归)。
- 无监督学习:从无标签数据中发现结构,如聚类(K-means、层次聚类)、降维(PCA、t-SNE)。
- 半监督学习:结合少量标注数据与大量未标注数据。
- 强化学习:智能体通过与环境交互,基于奖励信号学习最优策略(如Q-learning、策略梯度)。
3.2 模型评估与选择
- 数据集划分:训练集、验证集、测试集。
- 评估指标:准确率、精确率、召回率、F1分数、ROC曲线与AUC、均方误差(MSE)等。
- 过拟合与欠拟合:偏差-方差权衡,正则化(L1/L2)、Dropout、早停等技术。
- 交叉验证:k折交叉验证,确保模型泛化能力评估的可靠性。
3.3 特征工程
数据预处理(缺失值处理、归一化/标准化)、特征选择(过滤式、包裹式、嵌入式)、特征提取(文本TF-IDF、图像边缘特征)是提升模型性能的关键环节。
四、深度学习基础知识
深度学习通过多层神经网络自动学习层次化特征表示。
4.1 神经网络基础
- 神经元模型:加权求和、激活函数(Sigmoid、Tanh、ReLU、Softmax)。
- 前馈神经网络(MLP):全连接层、隐藏层、输出层。
- 损失函数:交叉熵损失(分类)、均方误差(回归)。
- 反向传播算法:利用链式法则计算梯度,更新网络权重。
4.2 主流网络架构
- 卷积神经网络(CNN):卷积层、池化层、全连接层,适用于图像处理。
- 循环神经网络(RNN):处理序列数据,变体包括LSTM、GRU,用于自然语言处理与时序预测。
- Transformer:基于自注意力机制,成为NLP领域的主流架构(如BERT、GPT)。
- 生成模型:生成对抗网络(GAN)、变分自编码器(VAE)、扩散模型(Diffusion Models)。
4.3 训练技巧
- 权重初始化:Xavier、He初始化。
- 批归一化(BatchNorm):加速训练并提升稳定性。
- 学习率调度:步长衰减、余弦退火、预热。
- 正则化策略:Dropout、权重衰减、数据增强。
五、人工智能关键技术
- 计算机视觉:图像分类、目标检测(YOLO、Faster R-CNN)、语义分割、人脸识别。
- 自然语言处理:词嵌入(Word2Vec、GloVe)、机器翻译、情感分析、问答系统、大语言模型(LLM)。
- 语音处理:语音识别(ASR)、语音合成(TTS)、声纹识别。
- 知识图谱:实体识别、关系抽取、图数据库与推理。
- 强化学习:深度强化学习(DQN、PPO)、多智能体系统、游戏AI与机器人控制。
六、人工智能基础软件开发
开发AI基础软件需要整合算法、框架与工程实践,构建可复用的AI系统。
6.1 开发环境与工具
- 编程语言:Python为主流,辅以C++/CUDA进行高性能计算。
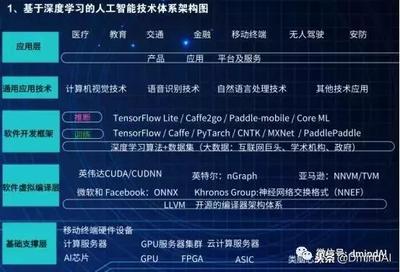
- 深度学习框架:TensorFlow、PyTorch、Keras、PaddlePaddle、MXNet。
- 数据处理库:NumPy、Pandas、SciPy、scikit-learn。
- 可视化工具:Matplotlib、Seaborn、TensorBoard。
6.2 软件开发流程
- 需求分析:明确AI要解决的具体问题与性能指标。
- 数据准备:数据采集、清洗、标注、划分与增强。
- 模型设计与训练:选择合适的模型架构,设置超参数,进行训练与调优。
- 模型评估与验证:使用交叉验证与测试集评估模型泛化能力。
- 部署与集成:模型导出(ONNX、TorchScript)、服务化(REST API、gRPC)、边缘部署(TensorRT、OpenVINO)。
- 监控与维护:持续监控模型性能,进行在线学习或定期重训练,处理数据漂移。
6.3 工程化实践
- 版本控制:Git管理代码,DVC管理数据与模型版本。
- 实验管理:MLflow、Weights & Biases跟踪实验参数与结果。
- 流水线自动化:CI/CD for ML(MLOps),实现自动化训练、测试与部署。
- 容器化:Docker封装环境,Kubernetes编排分布式训练与服务。
- 模型压缩:剪枝、量化、知识蒸馏,满足边缘设备部署需求。
6.4 一个简单示例:图像分类基础软件开发
以PyTorch为例,构建一个卷积神经网络进行图像分类:
`python
import torch
import torch.nn as nn
import torch.optim as optim
from torchvision import datasets, transforms
1. 数据加载与预处理
transform = transforms.Compose([transforms.ToTensor(), transforms.Normalize((0.5,), (0.5,))])
trainset = datasets.MNIST('./data', train=True, download=True, transform=transform)
trainloader = torch.utils.data.DataLoader(trainset, batch_size=64, shuffle=True)
2. 定义模型
class SimpleCNN(nn.Module):
def init(self):
super().init()
self.conv1 = nn.Conv2d(1, 32, 3, 1)
self.conv2 = nn.Conv2d(32, 64, 3, 1)
self.fc1 = nn.Linear(641212, 128)
self.fc2 = nn.Linear(128, 10)
self.relu = nn.ReLU()
self.pool = nn.MaxPool2d(2)
self.dropout = nn.Dropout(0.5)
def forward(self, x):
x = self.pool(self.relu(self.conv1(x)))
x = self.pool(self.relu(self.conv2(x)))
x = x.view(-1, 641212)
x = self.dropout(self.relu(self.fc1(x)))
x = self.fc2(x)
return x
model = SimpleCNN()
criterion = nn.CrossEntropyLoss()
optimizer = optim.Adam(model.parameters(), lr=0.001)
3. 训练循环
for epoch in range(5):
for images, labels in trainloader:
optimizer.zero_grad()
output = model(images)
loss = criterion(output, labels)
loss.backward()
optimizer.step()
print(f'Epoch {epoch+1}, Loss: {loss.item():.4f}')`
七、学习路径与资源推荐
- 入门阶段:吴恩达《机器学习》课程、3Blue1Brown神经网络系列、周志华《机器学习》。
- 进阶阶段:Ian Goodfellow《深度学习》、PyTorch官方教程、Kaggle竞赛实践。
- 专项深入:CS231n(计算机视觉)、CS224n(自然语言处理)、强化学习(Sutton & Barto)。
##
人工智能基础知识体系庞大而丰富,从数学理论到软件工程,每个环节都至关重要。掌握上述知识点并辅以持续的代码实践,读者将能逐步构建起完整的AI知识图谱,为深入研究和应用开发打下坚实基础。记住,AI学习是一场马拉松,坚持理论与实践相结合,方能行稳致远。
如若转载,请注明出处:http://www.xuetaotie.com/product/57.html
更新时间:2026-11-21 19:53:42